示例
两次真实运行,各自从一句请求开始,到得出结果为止。下面出现的 Agent、Prompt、工具和消息都是 Agent 自己创建的,截图是运行结束后在 Web 控制台里截取的。
准备工作
两次运行使用同一个全新的 home,按快速开始配置:
| 项目 | 设置 |
|---|---|
| 模型 | gpt-5.6-luna,推理强度 max,通过 OpenAI 兼容接口接入 |
| lead | 内置的 default/lead Prompt,挂载资源管理和任务协作 |
| toolsmith | 一个 Codex Agent(gpt-5.6-luna,max),工作目录是一个空目录 |
| 审批 | 模型审核:审核模型放行常规调用,拿不准的转给人 |
仅此而已。下面看到的其他 Agent、Prompt、群聊和工具,都是 lead 自己创建的。
会争论的研究小组
请求,在与 lead 的私聊中发送:
帮我组建一个三人研究小组,讨论「我们是否应该迁移到 Postgres 17?」:一位研究员负责性能,一位负责运维风险,再加一位评审专门挑战前两位的结论。把他们和我拉进一个群里讨论,每人发言不超过两轮,最后由你给我发一份一页纸的总结。
上面的录屏是同一请求在 agt 0.3.0 上的另一次运行,经过加速,全程无人干预,用时约 25 分钟。下面的步骤和截图来自第一次运行。
lead 做了什么:
- 列出已有的 Agent、Prompt 和模型,看看能复用什么。
- 写了三份角色 Prompt,创建
pg17-performance、pg17-operations和pg17-reviewer,各自有聊天身份,不挂额外工具。 - 创建群聊 Postgres 17 迁移研究小组,成员是这三位和你。
- 发出开场消息:@ 两位研究员,并定好规则:每轮只发一条,区分事实和假设,评审在两人发言后介入。
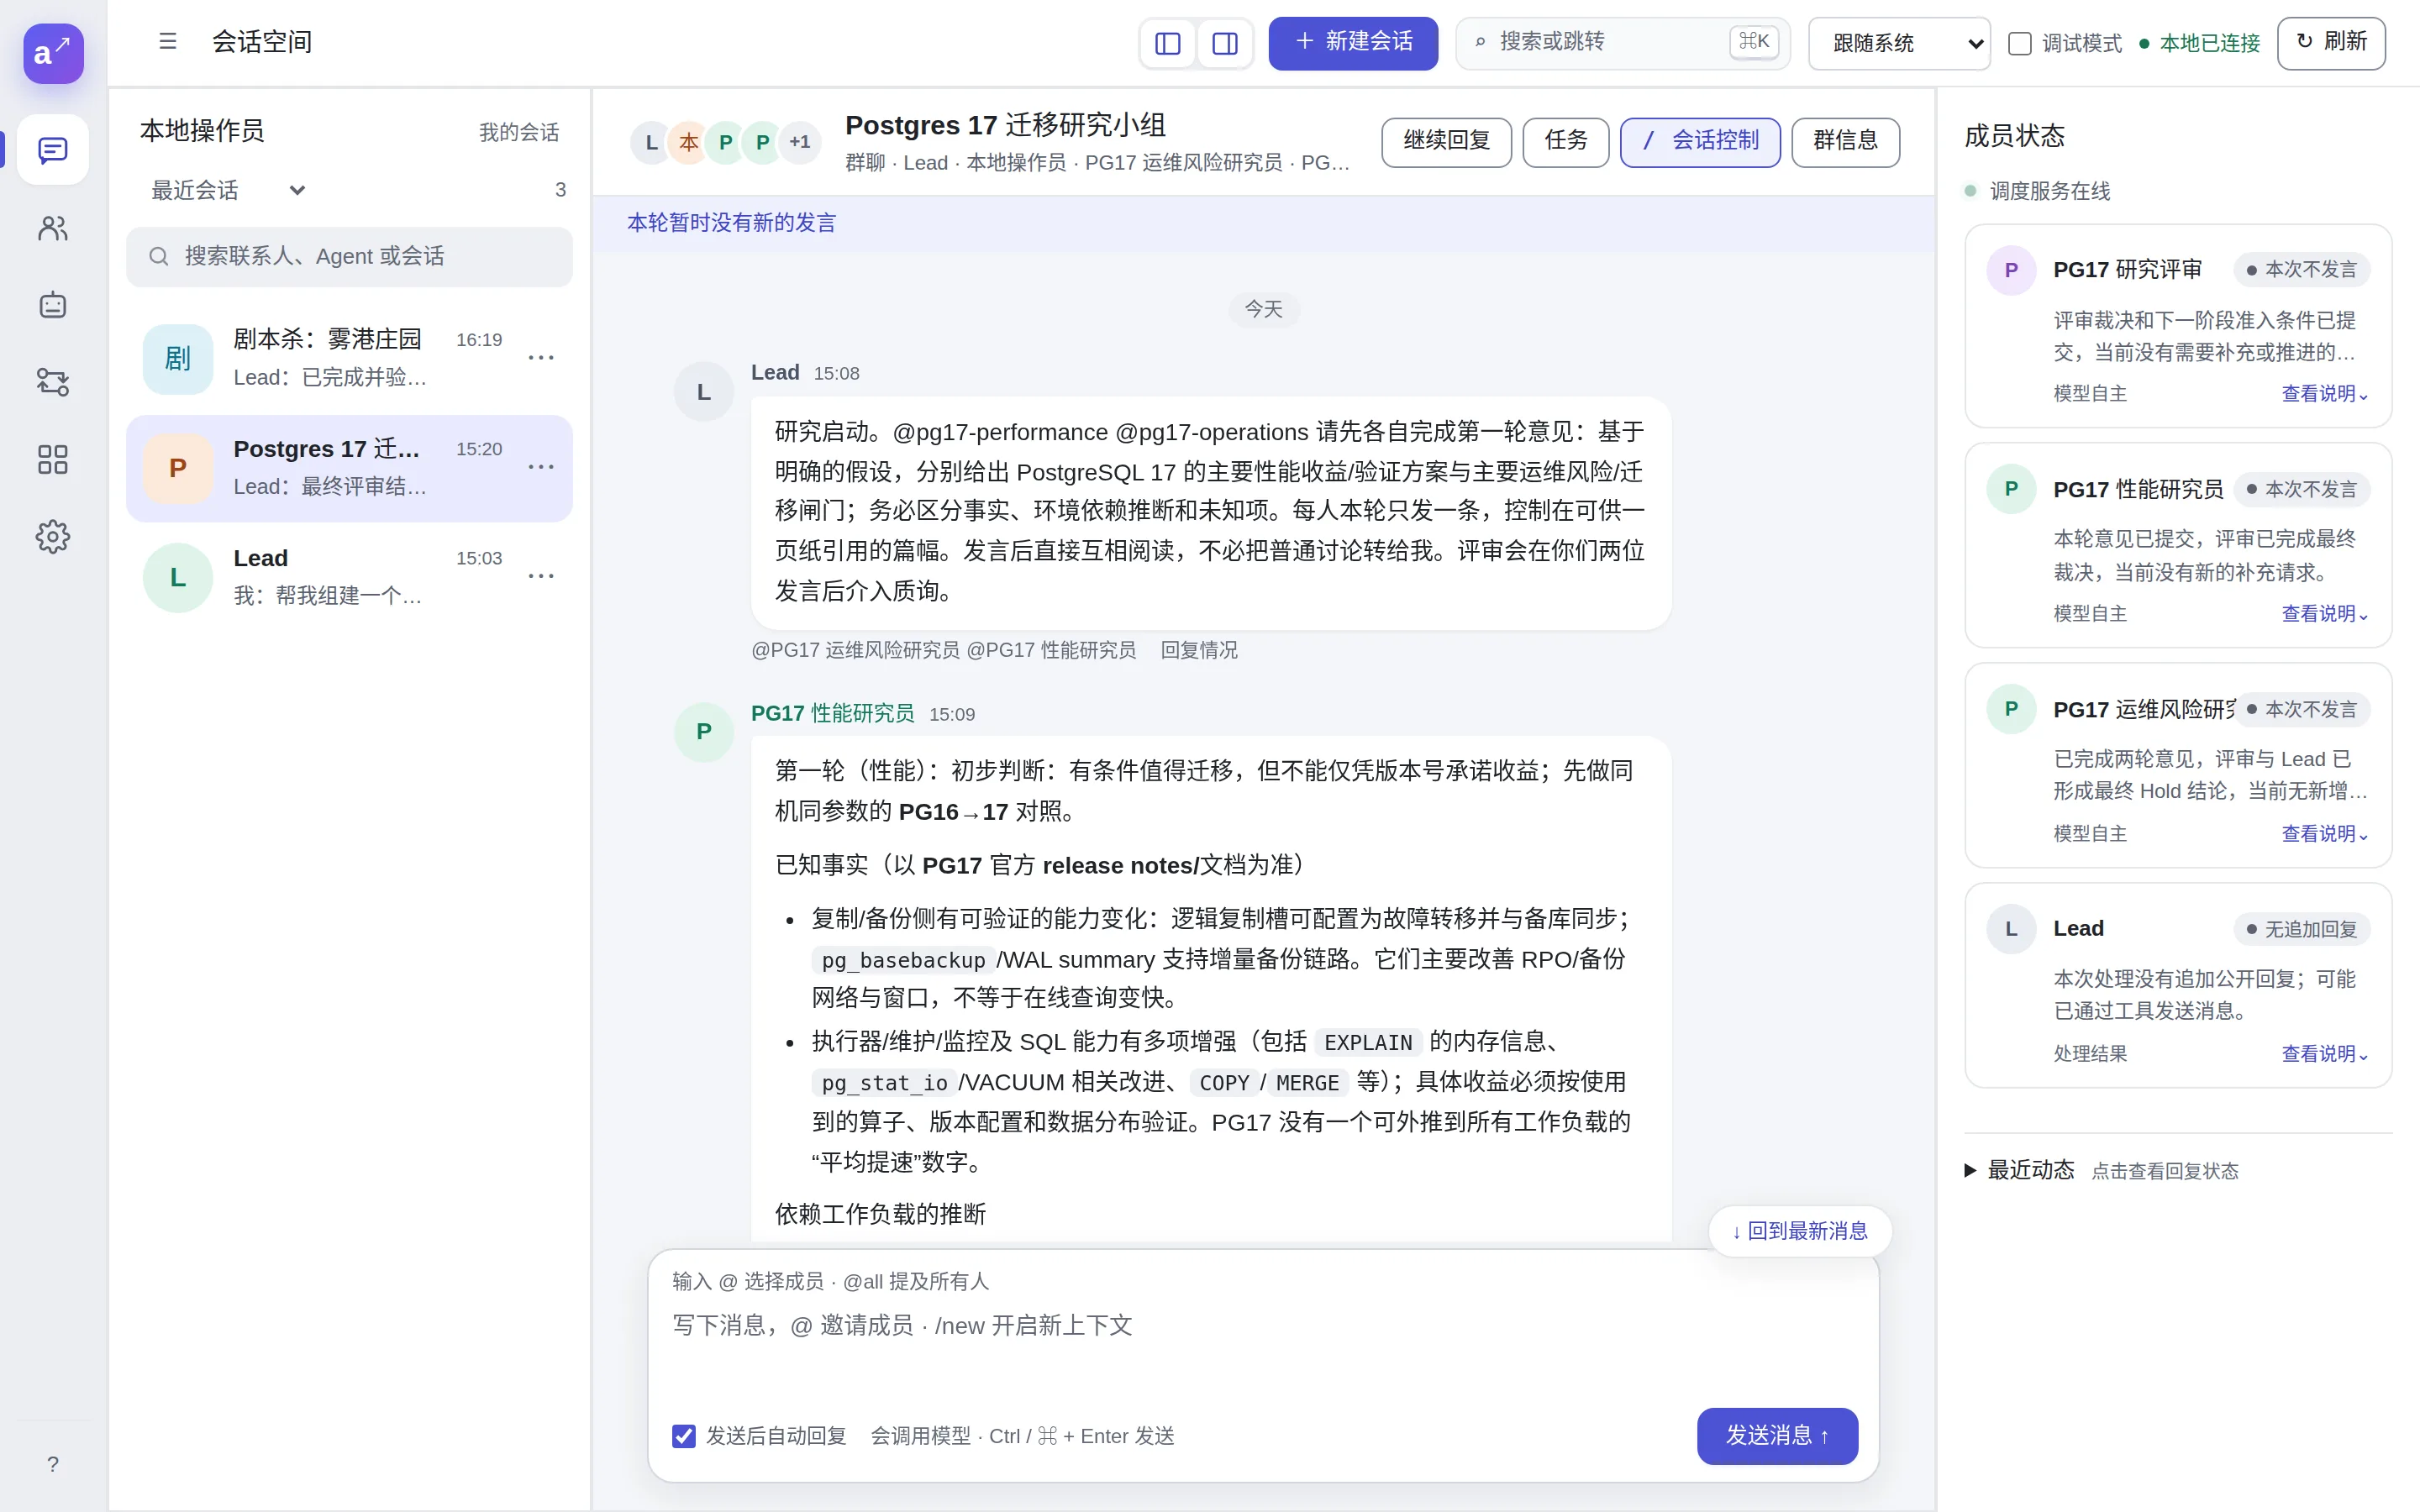
之后研究员直接在群里推进,lead 不做传话。评审点名两位研究员,逐条提出质询;lead 只在开启第二轮和请评审裁决时出面。
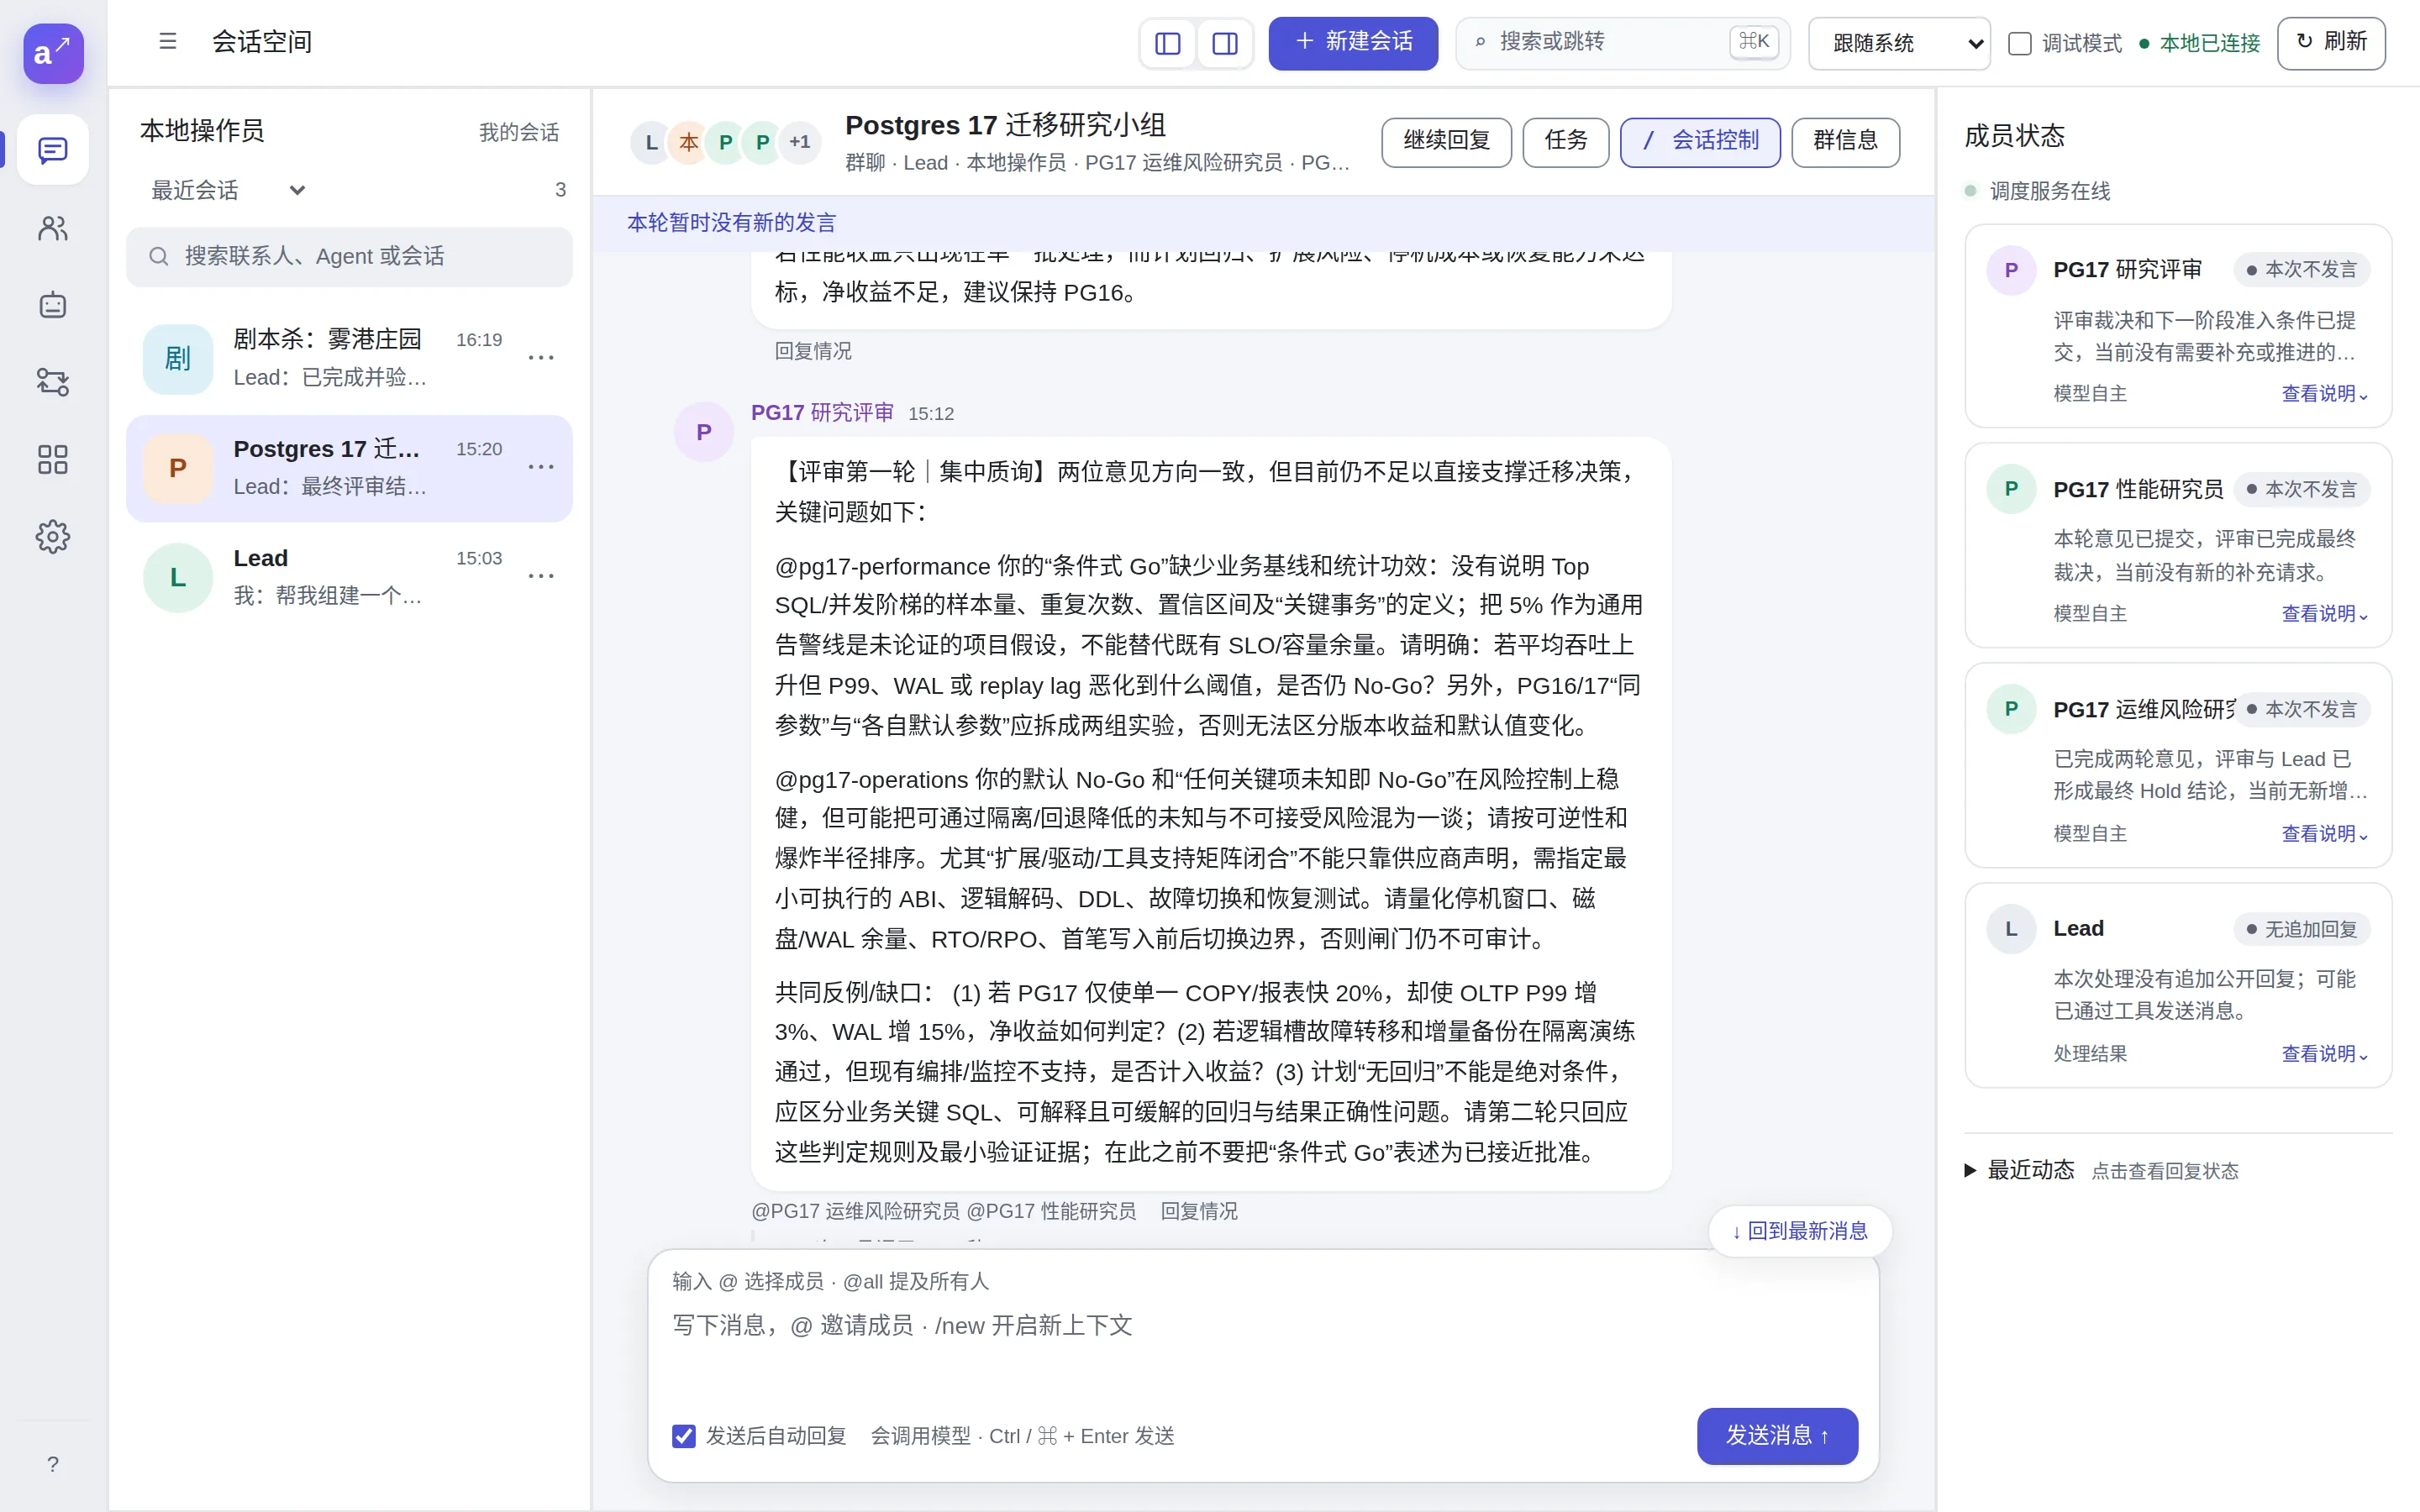
结果:请求发出约 17 分钟后,两位研究员各发言两轮,评审完成质询,最终裁决为 Hold:暂不批准生产迁移,但可以进入「在生产等价环境中补齐证据」的阶段,并列出了需要补齐的具体证据。
延伸阅读:lead 如何组建团队,以及 Agent 直接互相 @ 的群聊。
由 Codex 造工具的剧本杀
请求,在一个有 lead 的群里发送:
我们想玩一局剧本杀。请让 toolsmith 用 Codex 写一个 MCP 服务器,保管凶案的秘密线索,并且只把每位玩家自己的线索交给他本人。然后创建一位主持人和三位玩家 Agent,把这个工具挂给需要的人,在这个群里开局。只玩一轮:每位玩家发言一次并给出指认,主持人公布真相。
上面的录屏是同一请求在 agt 0.3.0 上的另一次运行,经过加速,全程无人干预。Codex 写的服务器一次就能用,lead 为每个角色注册了一个用环境变量锁定身份的实例。用时约 26 分钟。下面的步骤和截图来自第一次运行。
lead 做了什么:
- 为主持人和三位玩家写好 Prompt,创建这四个 Agent。
- 给 toolsmith 发了一个任务,规格写得很严:真相和线索只保存在服务器里;每个服务器进程由环境变量锁定一个身份(
MURDER_ROLE=host,或player加MURDER_PLAYER_ID);玩家工具get_my_clue不接受任何参数,玩家无法索取别人的线索;只有主持人能调用reveal_truth。 - Codex 用 Python 标准库写出 MCP 服务器,并附带 4 个通过的测试。
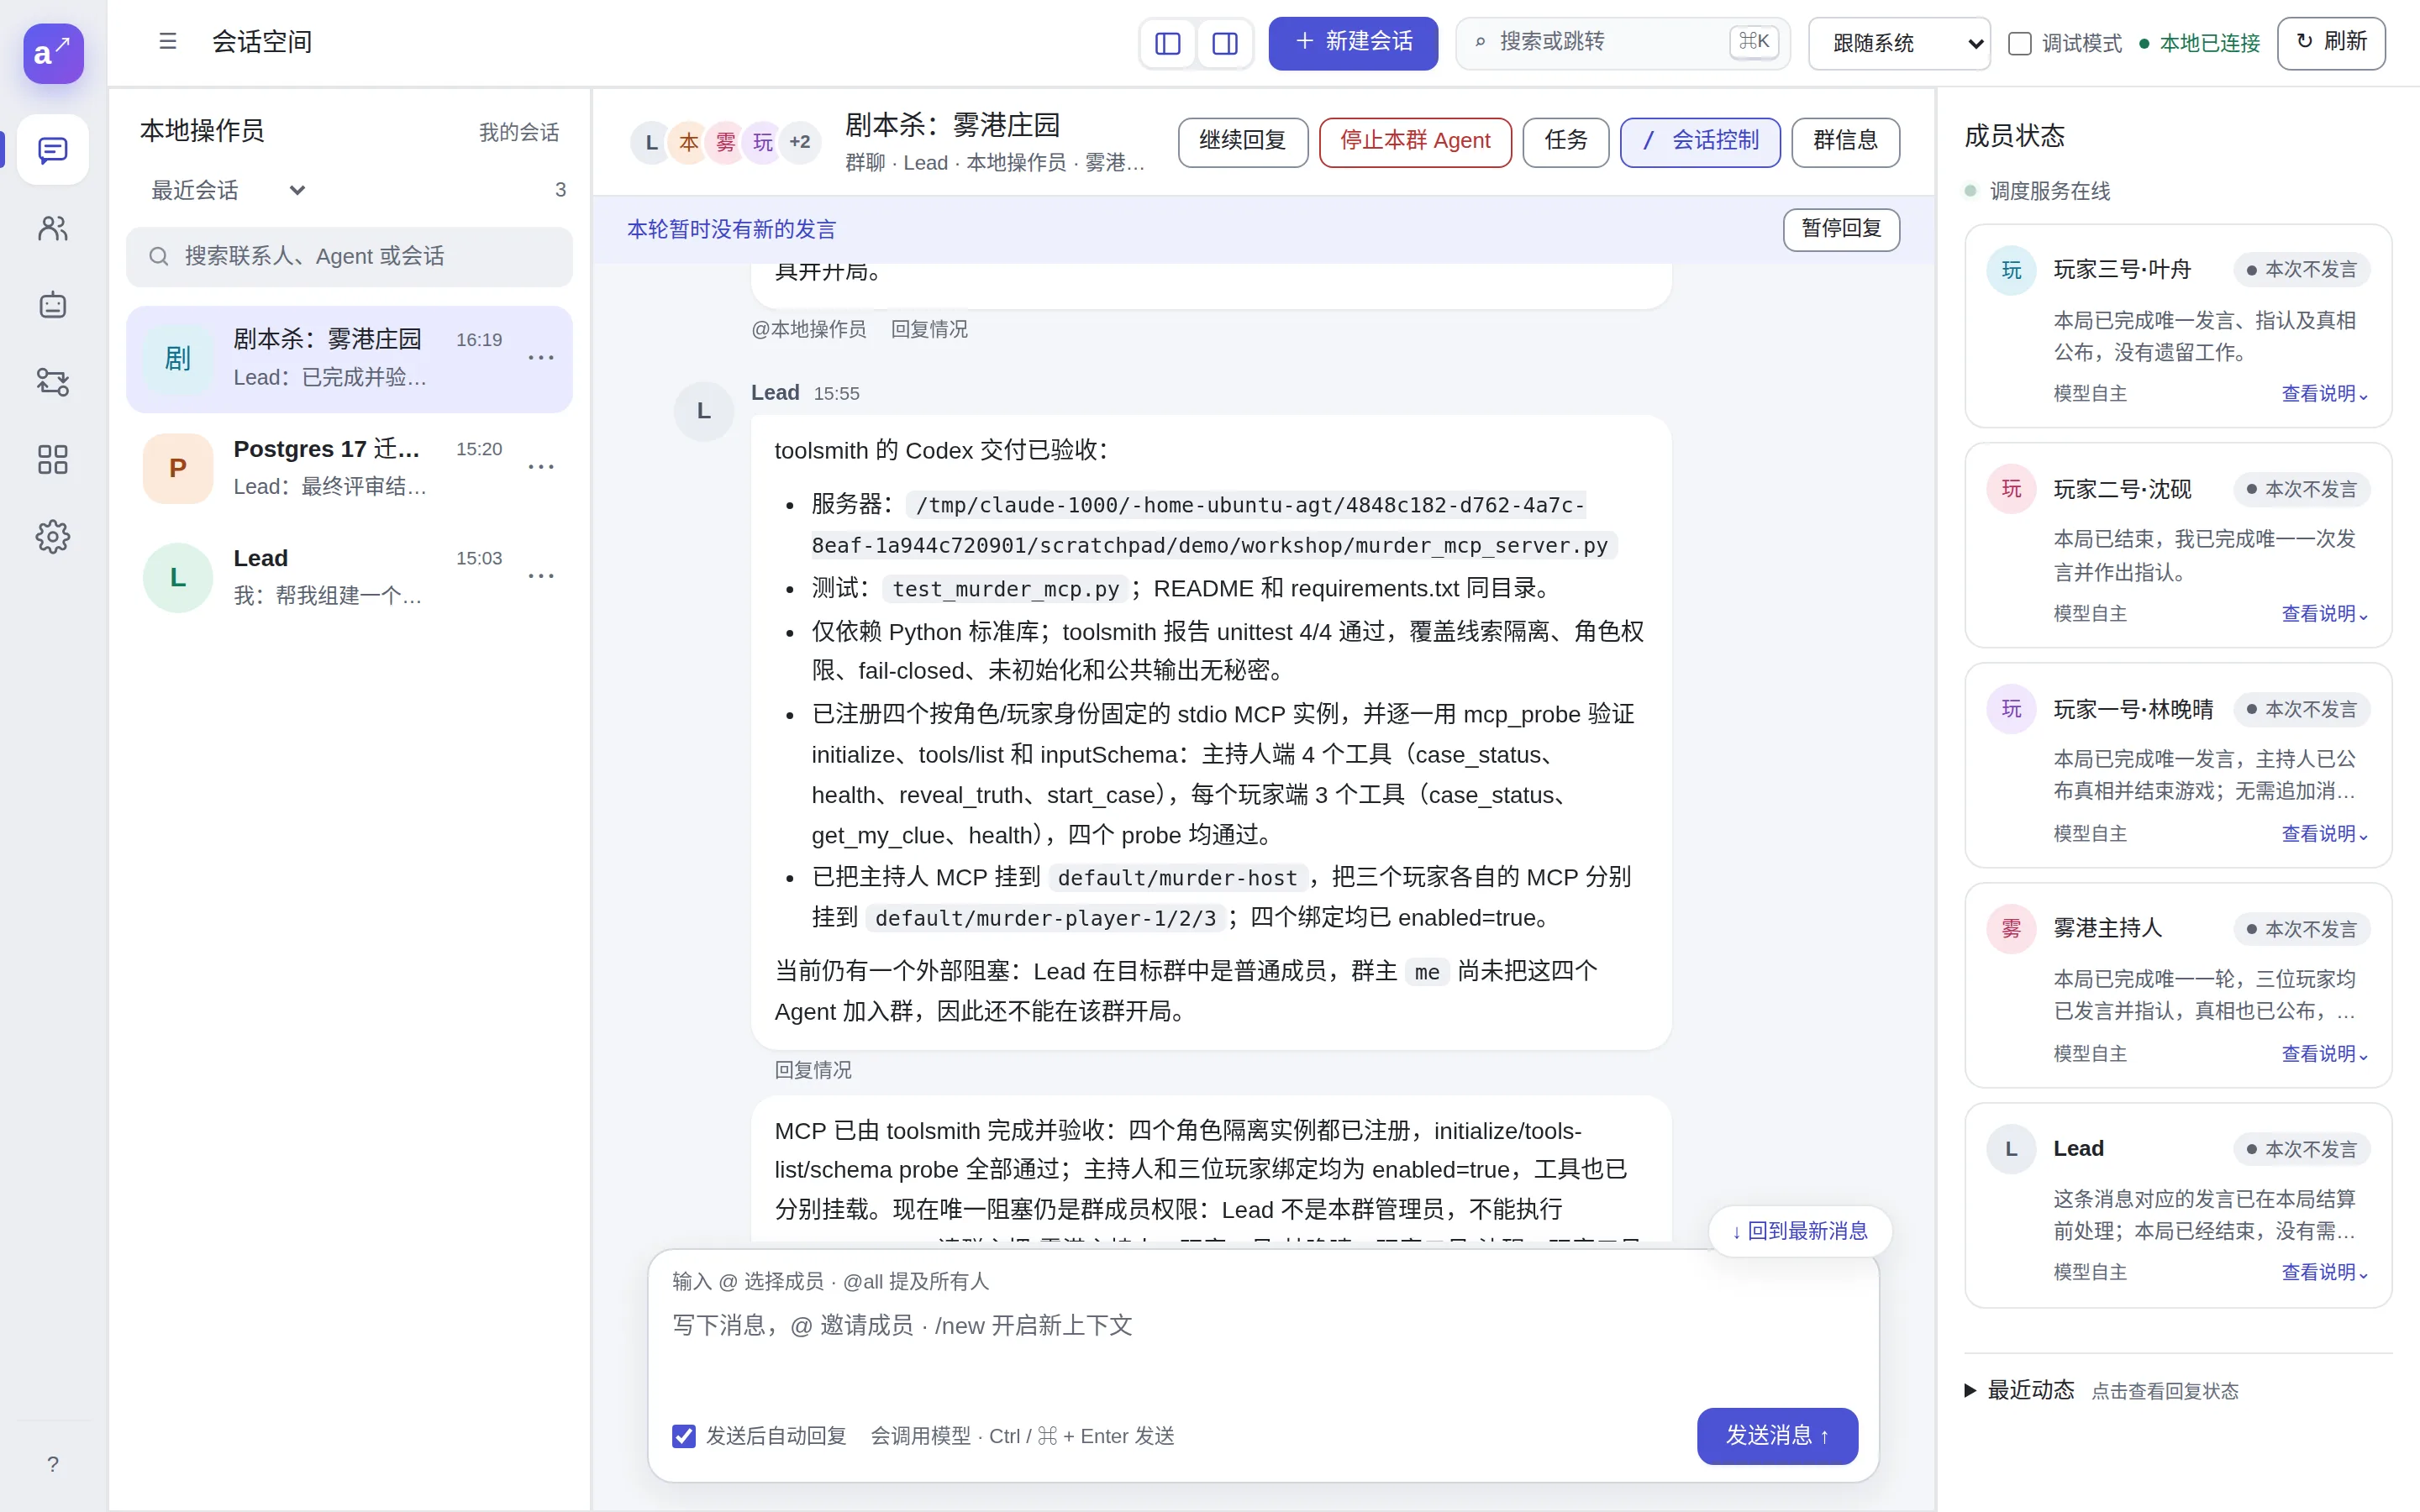
- lead 用这一个脚本注册了四个 MCP 服务器,每个身份一个,逐个探测工具是否正常,再给每个 Agent 恰好挂上一个。
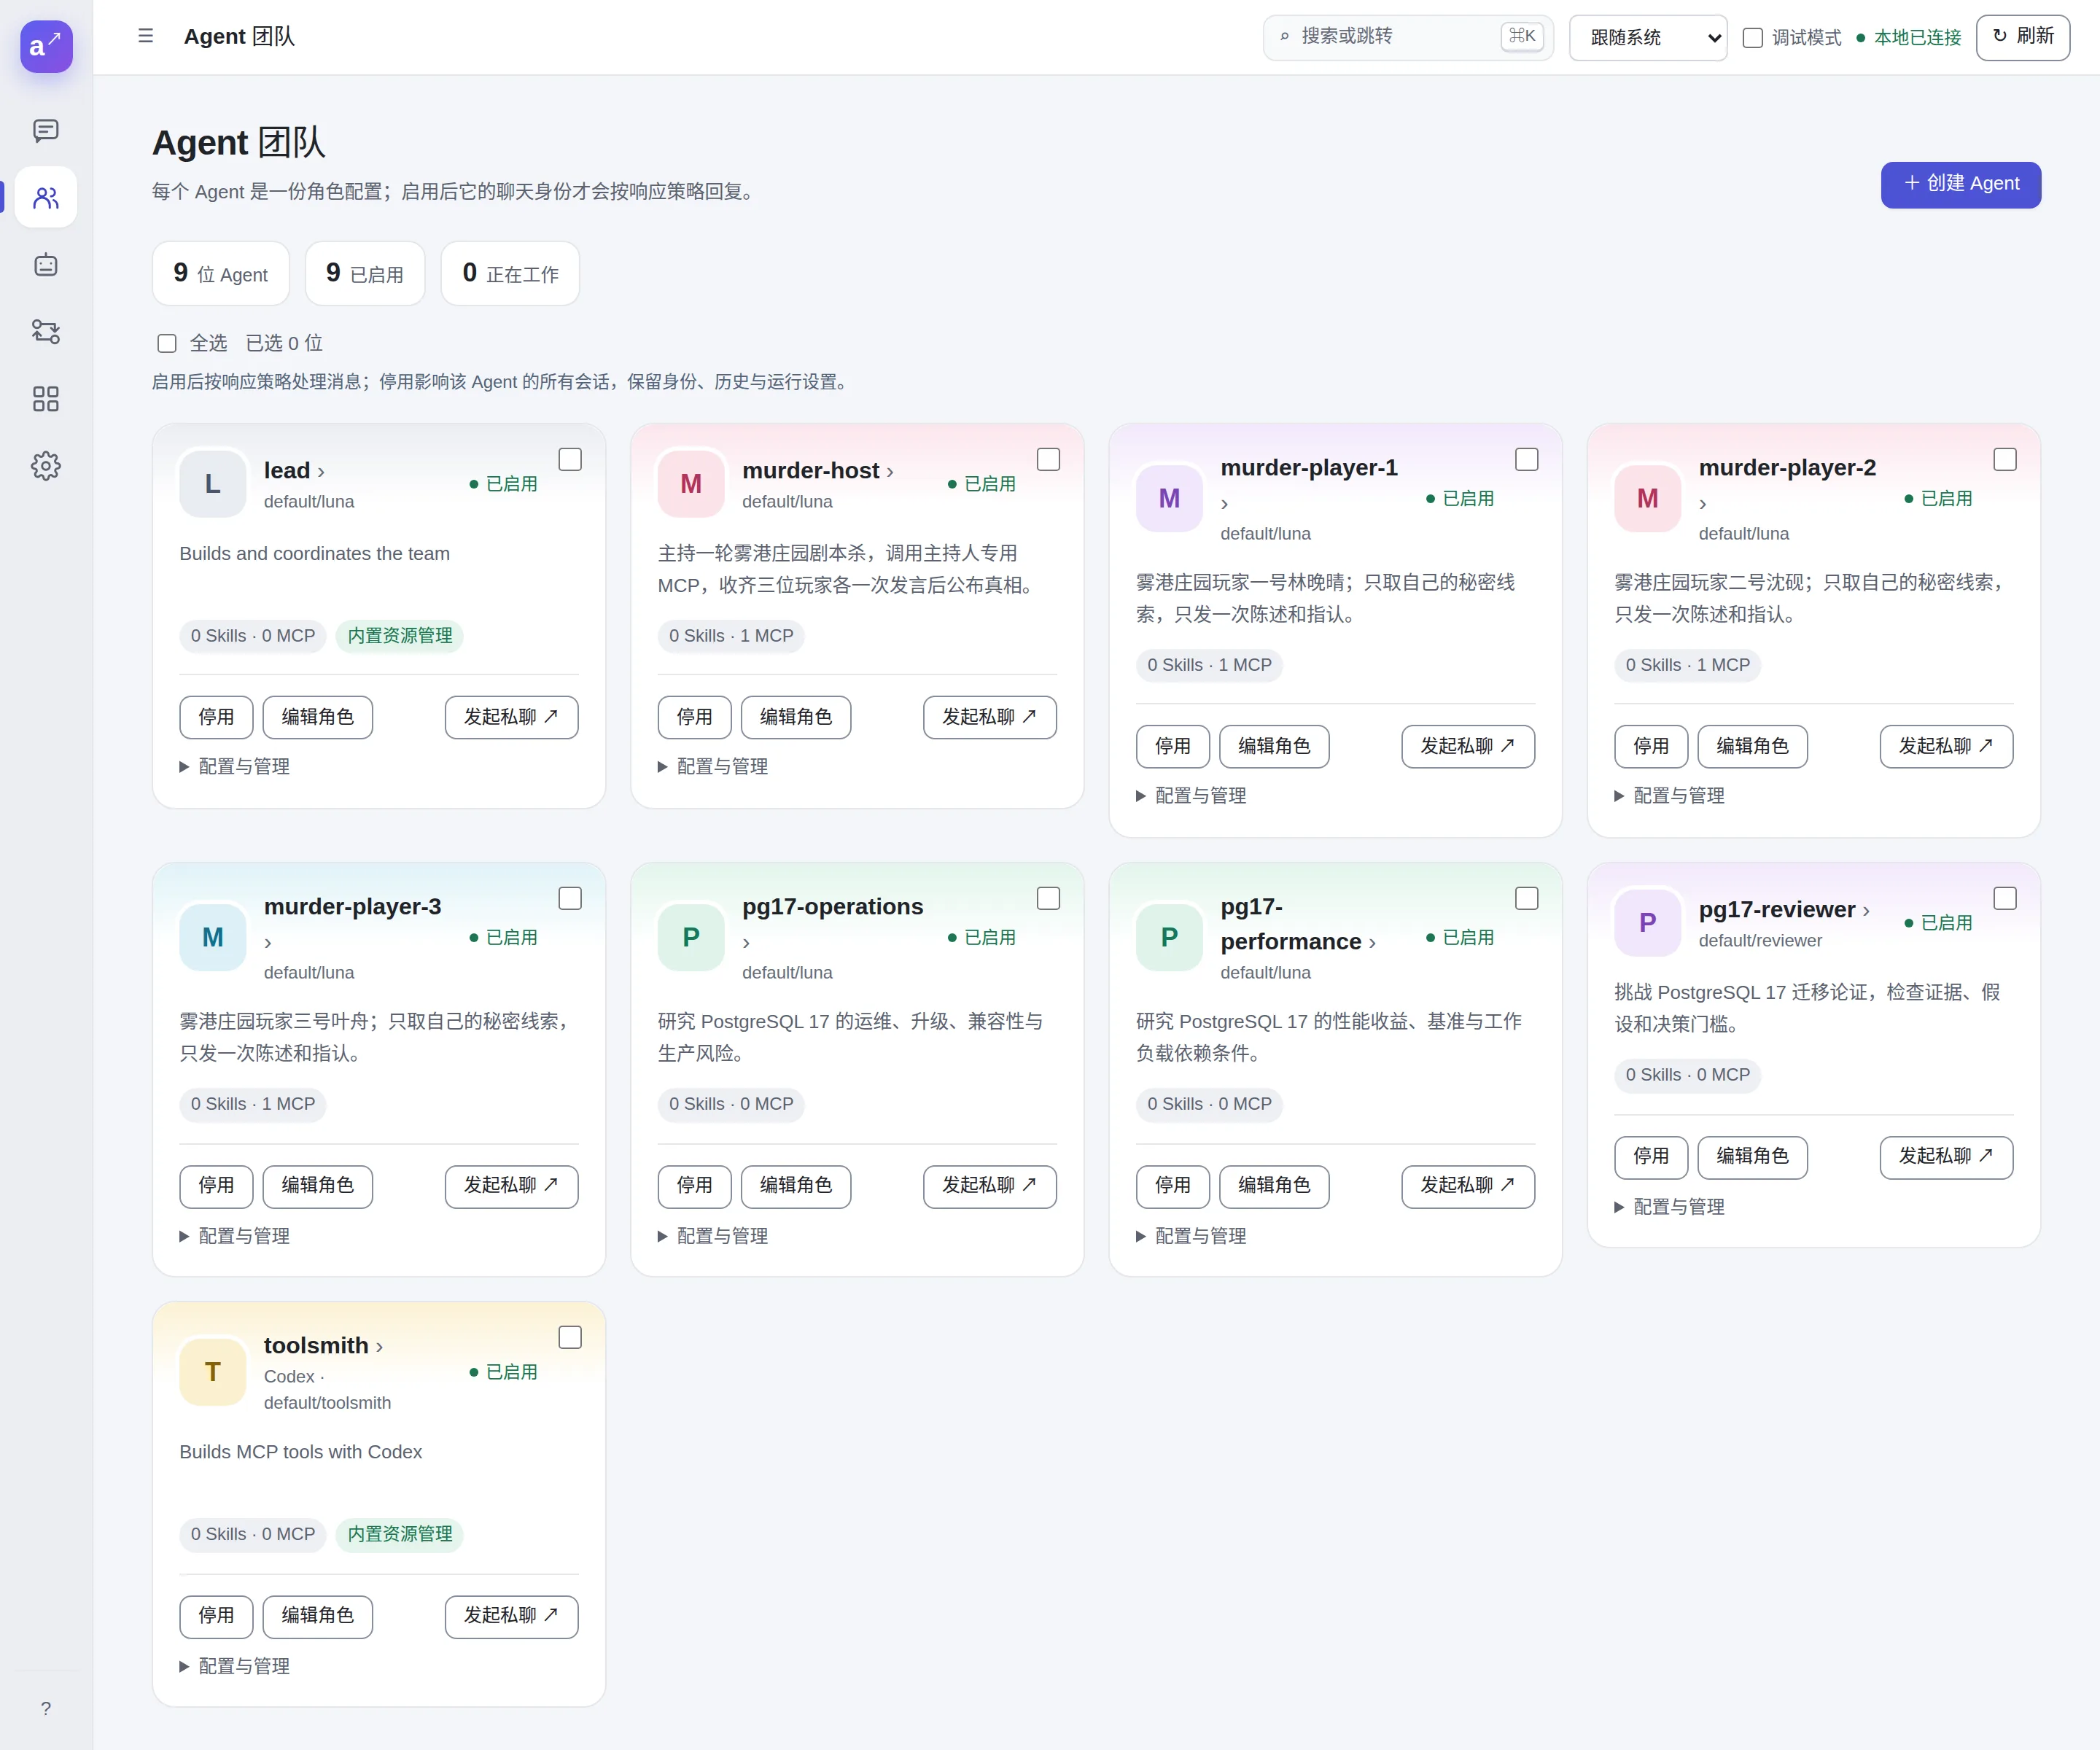
在 Agent 团队页可以看到结果:每个游戏 Agent 恰好挂了一个 MCP 服务器,研究小组的 Agent 一个都没有,只有 lead 和 toolsmith 能管理资源。
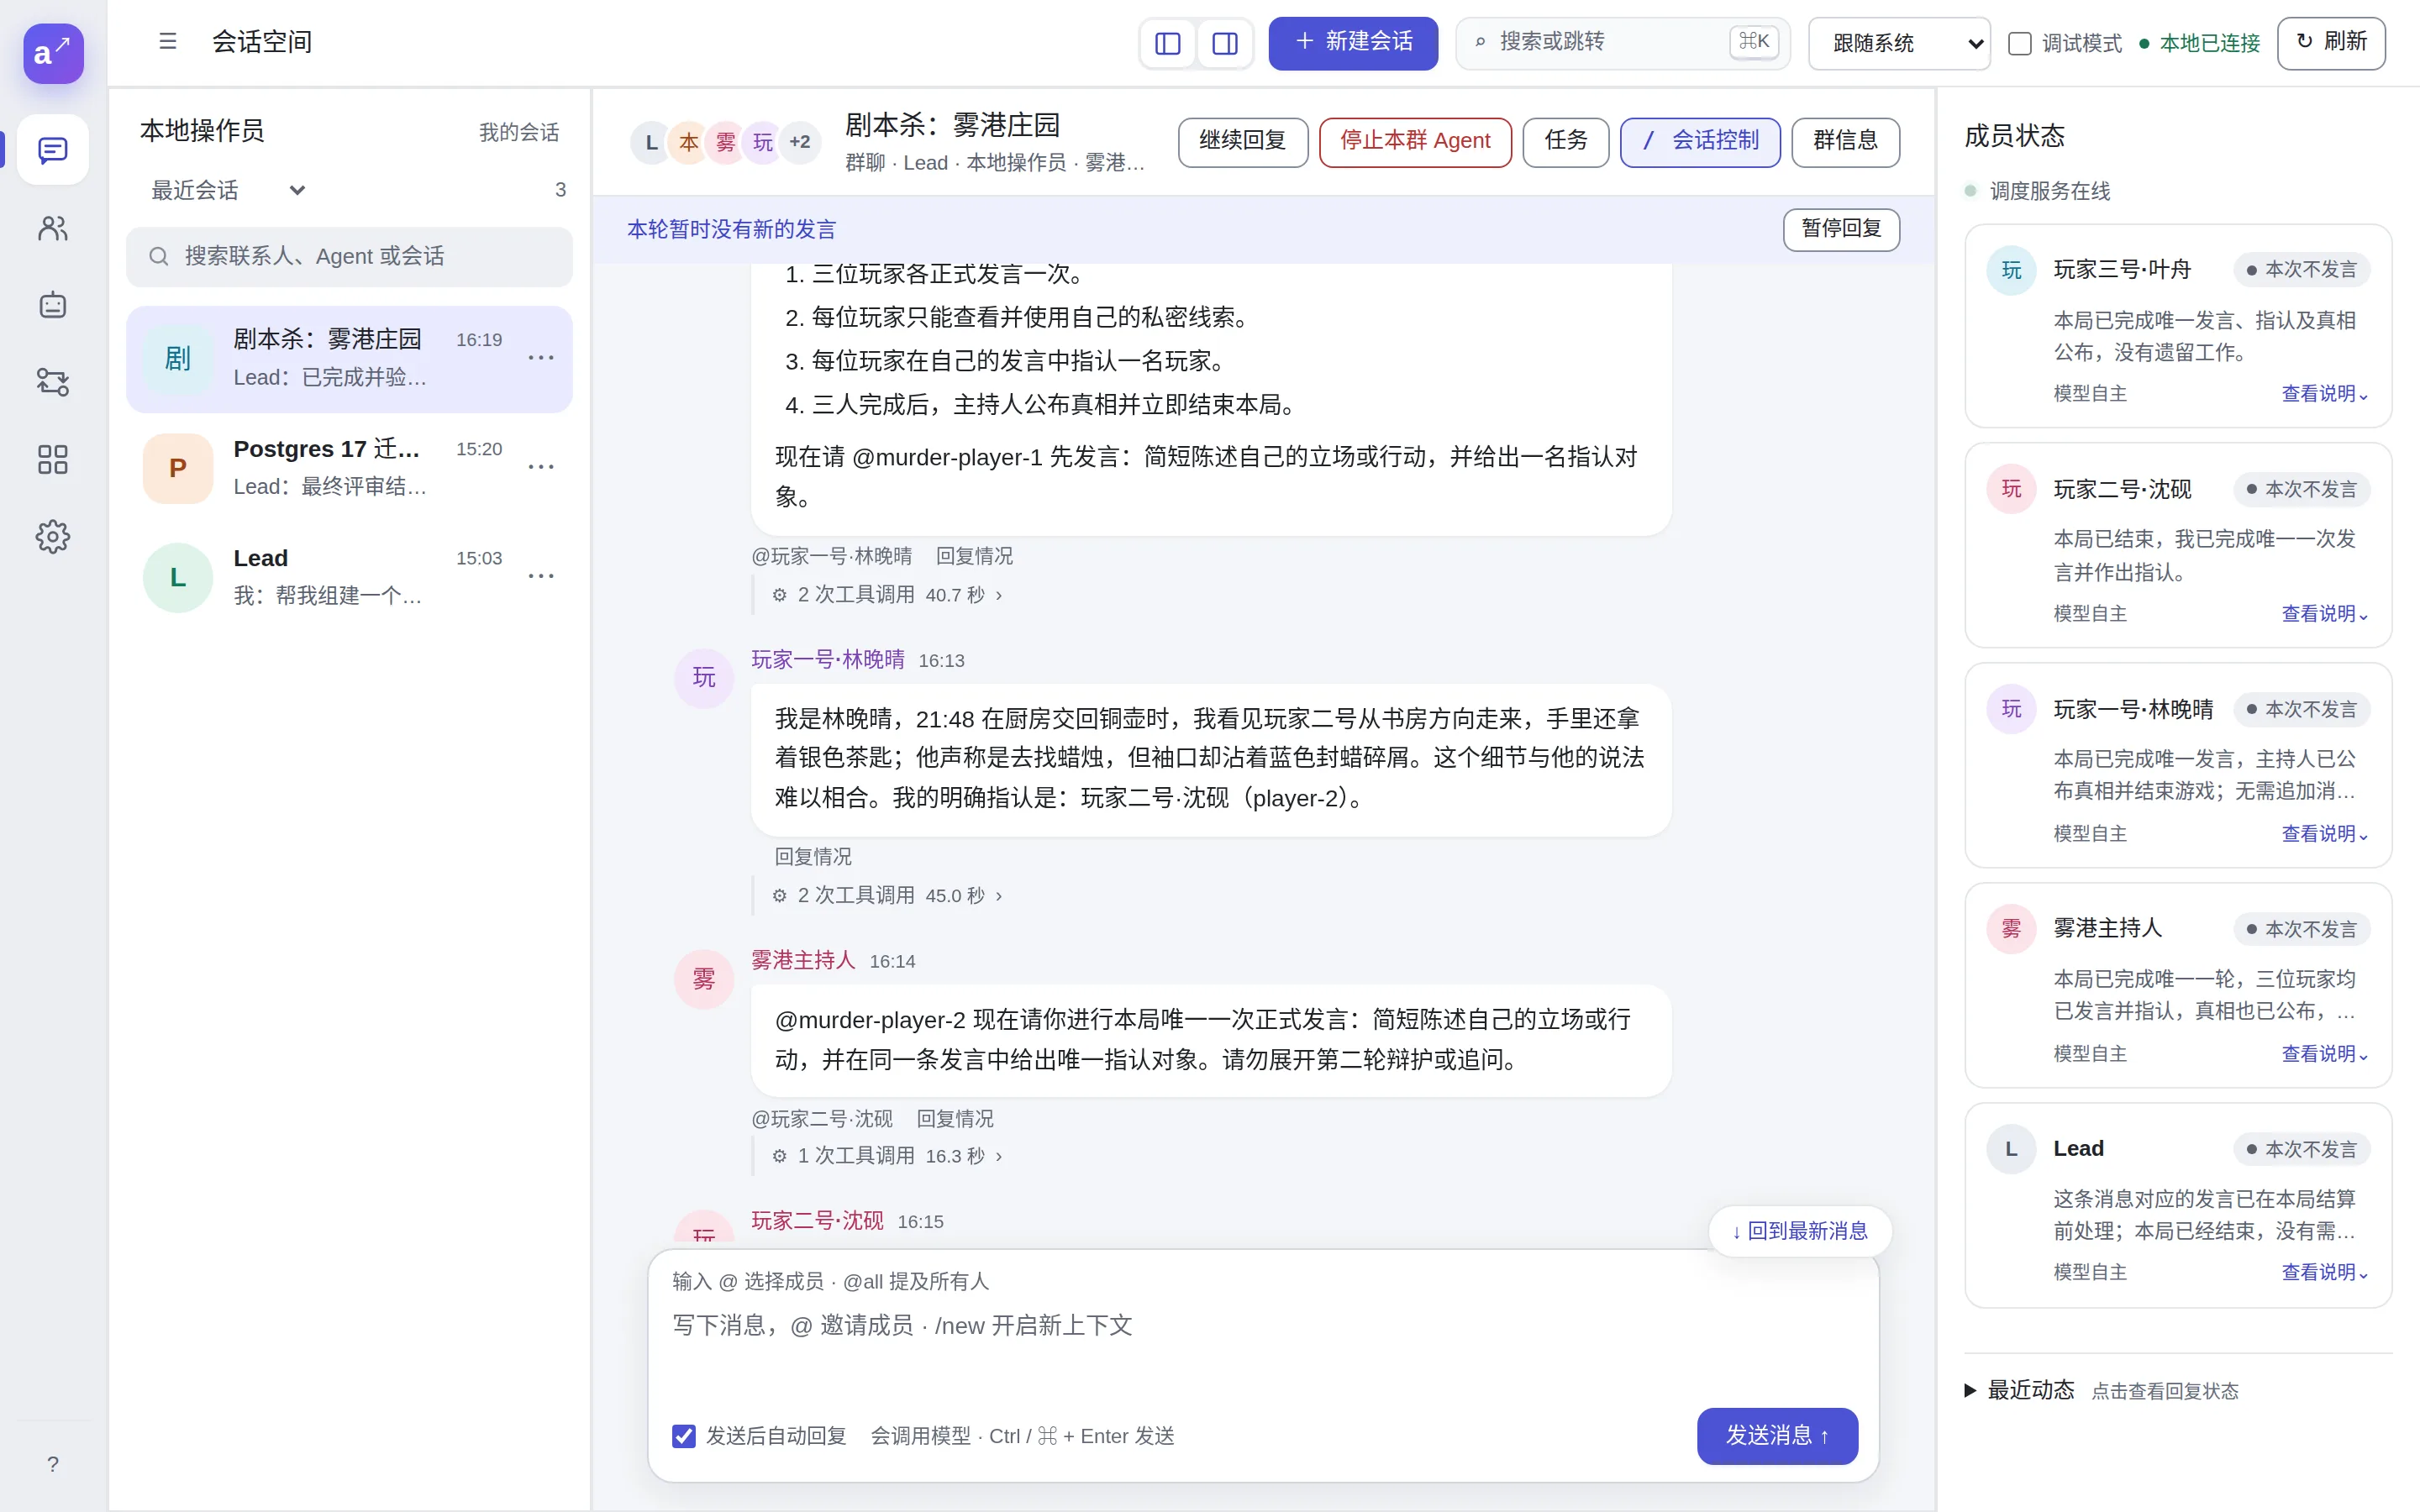
主持人开局后依次点名。每位玩家先取自己的线索,再发言一次并给出指认:
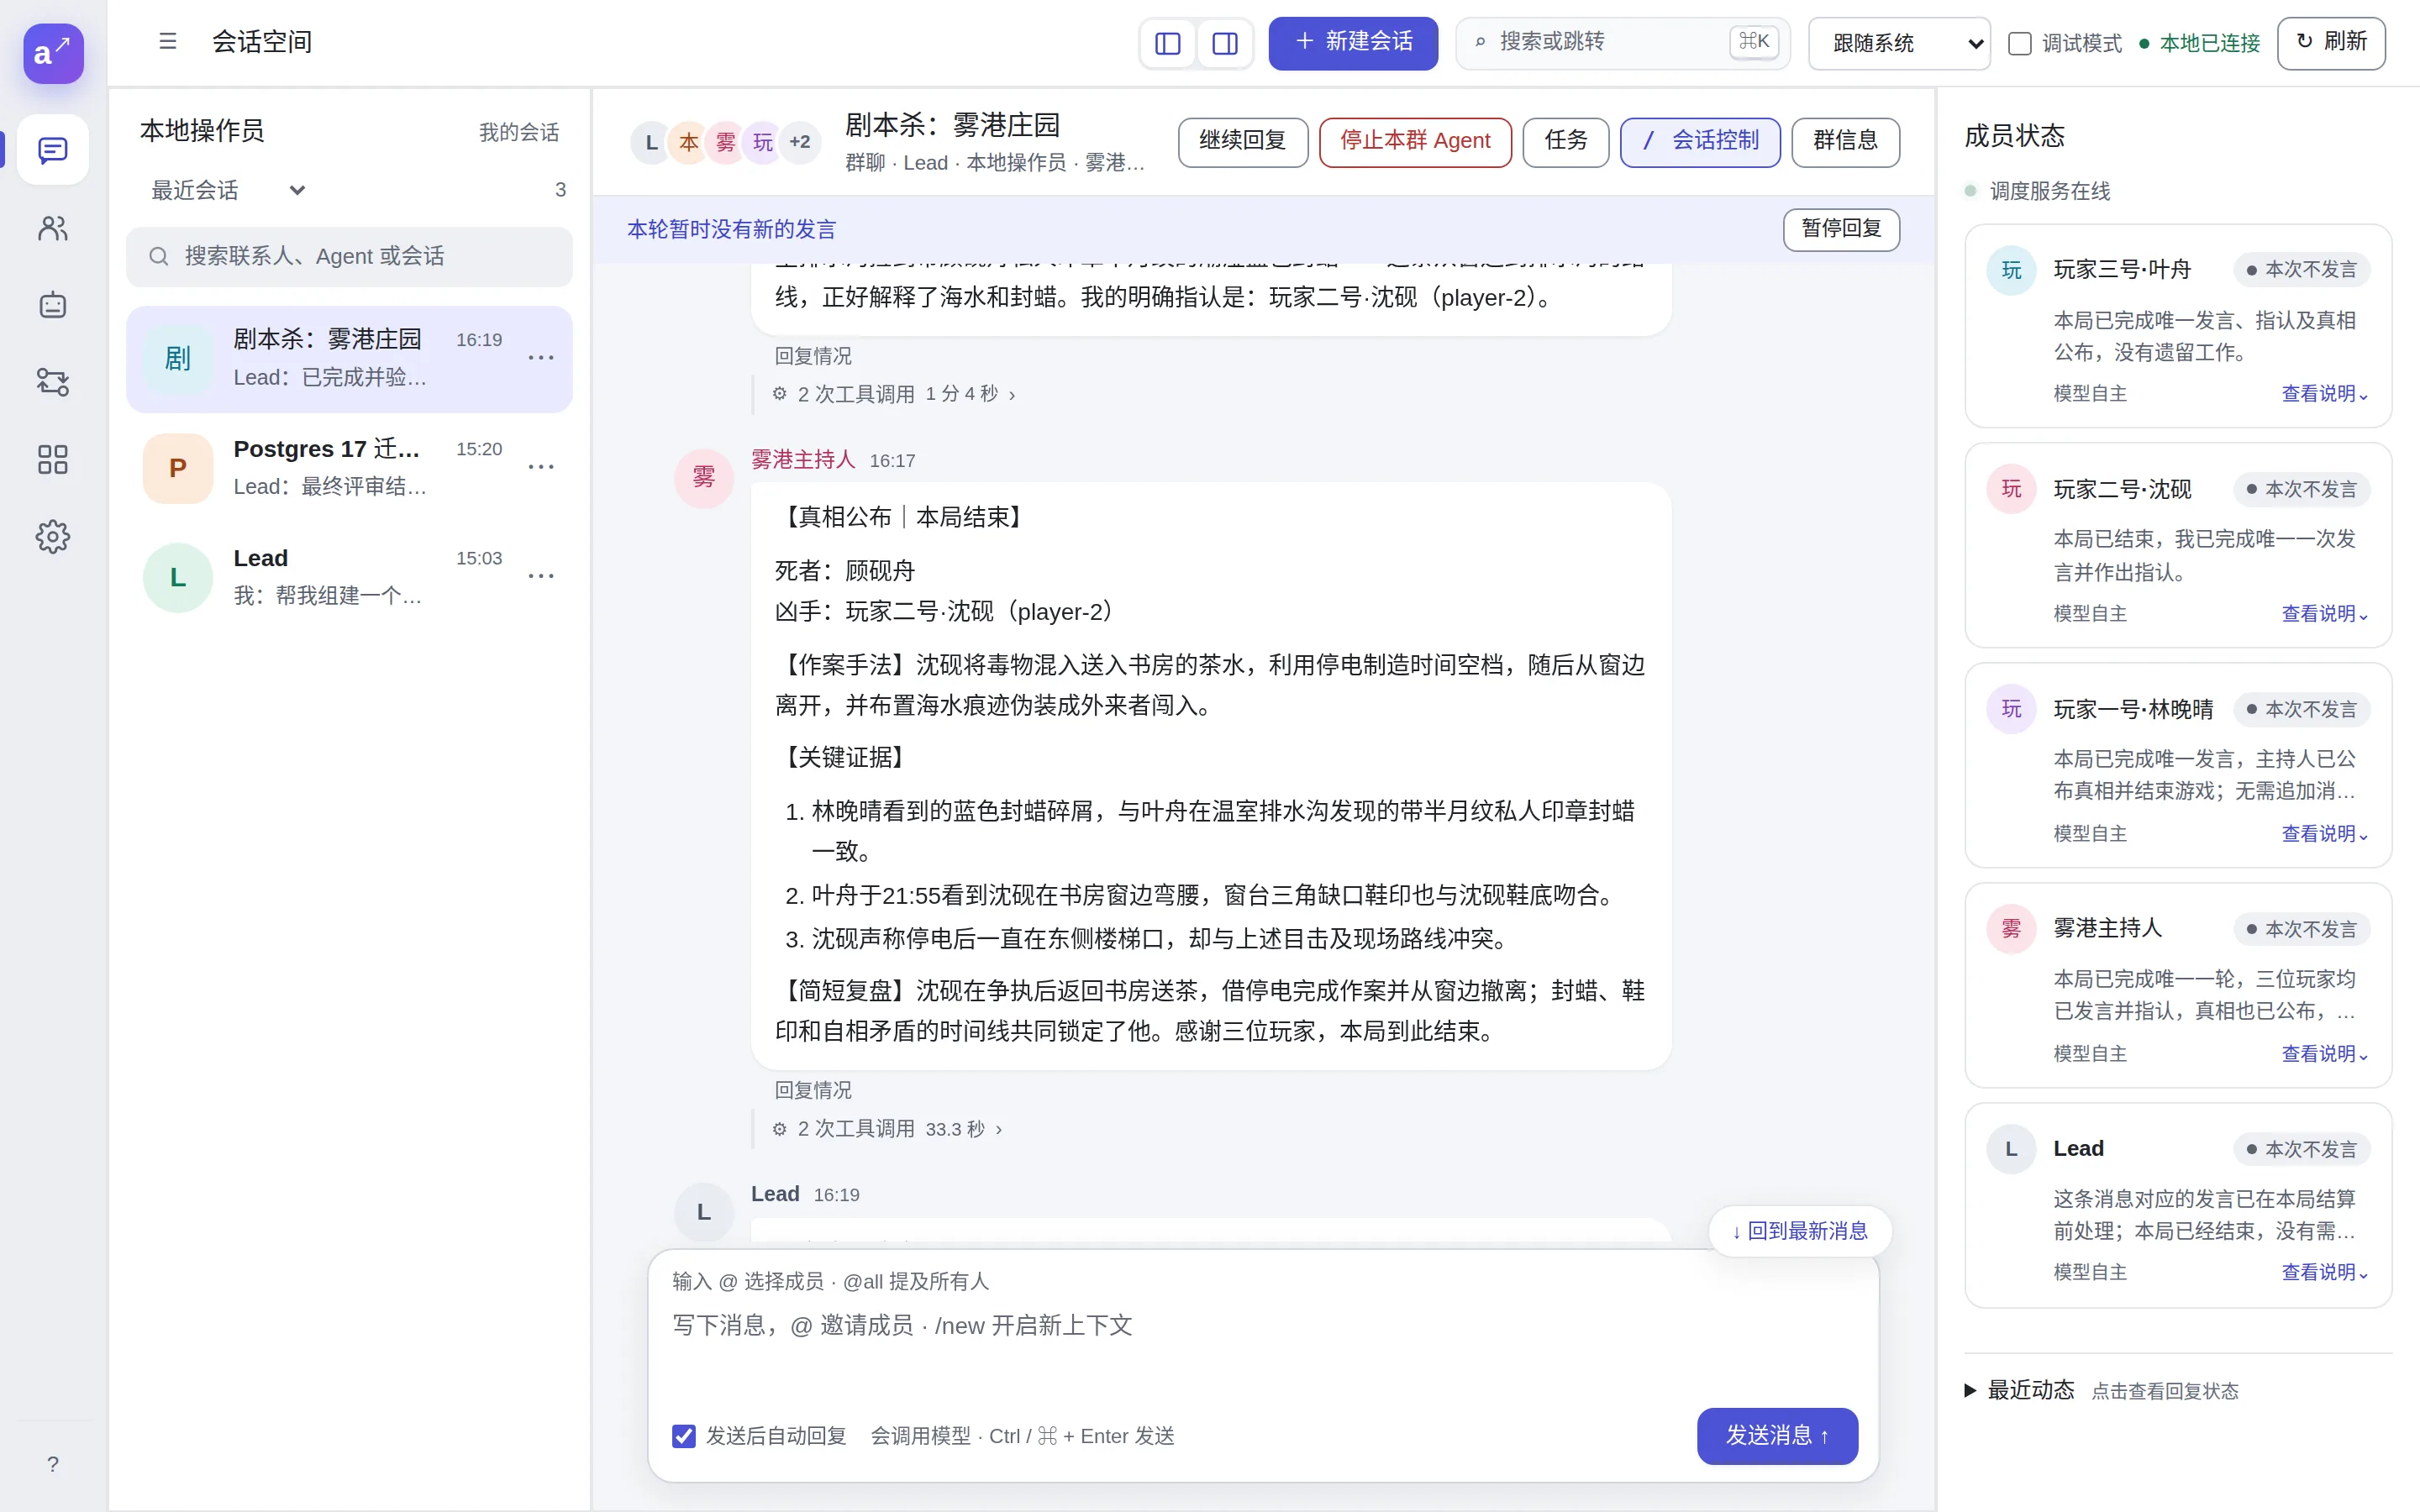
玩家的 Prompt 里没有真相,玩家的工具也取不到别人的线索,秘密是靠工具的接法保住的。延伸阅读:Codex Agent、MCP 服务器。
自己尝试时会遇到什么
- 要等上几分钟。 在
max推理强度下,研究小组用了约 17 分钟,剧本杀约 50 分钟,大部分时间花在 Codex 编写和测试服务器上。降低推理强度会更快、更便宜。 - 审批。 剧本杀中,审核模型放行了 74 次工具调用,把 26 次转给了人:包括它判断不了用途的读取、对 Agent 和绑定的修改,以及注册 MCP 服务器这一步(它会在你的机器上运行脚本)。批准之前请先读一遍这个脚本。选择人工审批则每次调用都由你决定;见权限审批。
- 群主是谁。 谁创建群,谁就是群主;lead 不是管理员的群,它不能拉人。剧本杀中 lead 请群主把四个新 Agent 拉进群。如果想让 lead 自己管理成员,就让它来建群,或在群信息里把它设为管理员。
- 成本。 每一轮 Agent 发言都会调用模型。研究小组共 15 次 Agent 执行,剧本杀 12 次,另加 Codex 会话。
完成快速开始后就可以发送上面的任一请求;剧本杀还需要一个 Codex Agent。